自定义查询
与其他所有 Spring Data 模块一样,Spring Data Neo4j 允许您在仓库中指定自定义查询。当您无法通过派生查询函数表达查找逻辑时,自定义查询会派上用场。
由于 Spring Data Neo4j 在底层高度以记录为导向地工作,请务必记住这一点:不要为同一个“根节点”构建包含多条记录的结果集。
另外请参阅常见问题(FAQ),了解从仓库使用自定义查询的其他形式,尤其是如何将自定义查询与自定义映射结合使用:自定义查询与自定义映射。
带关系的查询
当心笛卡尔积
假设您有一条类似 MATCH (m:Movie{title: 'The Matrix'})←[r:ACTED_IN]-(p:Person) return m,r,p 的查询,其结果如下所示:
+------------------------------------------------------------------------------------------+
| m        | r                                    | p                                      |
+------------------------------------------------------------------------------------------+
| (:Movie) | [:ACTED_IN {roles: ["Emil"]}]        | (:Person {name: "Emil Eifrem"})        |
| (:Movie) | [:ACTED_IN {roles: ["Agent Smith"]}] | (:Person {name: "Hugo Weaving})        |
| (:Movie) | [:ACTED_IN {roles: ["Morpheus"]}]    | (:Person {name: "Laurence Fishburne"}) |
| (:Movie) | [:ACTED_IN {roles: ["Trinity"]}]     | (:Person {name: "Carrie-Anne Moss"})   |
| (:Movie) | [:ACTED_IN {roles: ["Neo"]}]         | (:Person {name: "Keanu Reeves"})       |
+------------------------------------------------------------------------------------------+
这样的映射结果很可能无法使用。如果将其映射为一个列表,列表中会包含重复的 Movie,而这部电影只会有一条关系。
每个根节点只取一条记录
为了取回正确的对象,需要在查询中 collect(收集)关系和相关节点:MATCH (m:Movie{title: 'The Matrix'})←[r:ACTED_IN]-(p:Person) return m,collect(r),collect(p)
+------------------------------------------------------------------------+
| m        | collect(r)                     | collect(p)                 |
+------------------------------------------------------------------------+
| (:Movie) | [[:ACTED_IN], [:ACTED_IN], ...]| [(:Person), (:Person),...] |
+------------------------------------------------------------------------+
当结果是这样一条记录时,Spring Data Neo4j 就能把所有相关节点正确地添加到根节点上。
深入图的更深处
上面的示例假设您只想获取第一级相关节点。有时这还不够——图中更深处的节点也应当成为映射实例的一部分。有两种方式可以做到这一点:数据库端归约或客户端归约。
为此,上面的示例还应在与初始 Movie 一起返回的 Person 上包含 Movies。
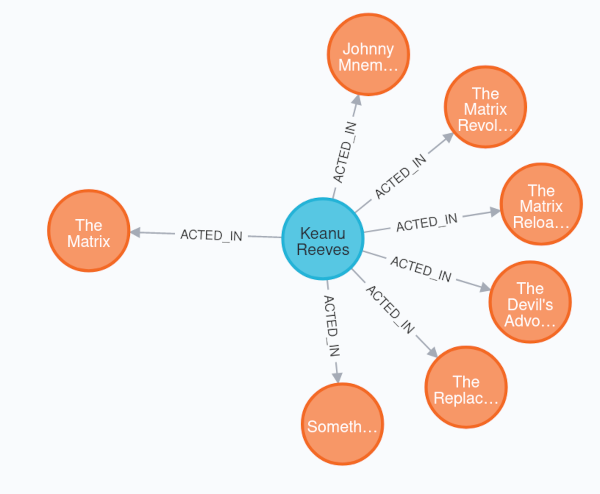
图 1.《黑客帝国》与 Keanu Reeves 示例
数据库端归约
请记住,Spring Data Neo4j 只能正确处理基于记录的结果,因此一个实体实例的结果必须位于同一条记录中。使用Cypher 的路径能力是获取图中所有分支的有效选项。
MATCH p=(m:Movie{title: 'The Matrix'})<-[:ACTED_IN]-(:Person)-[:ACTED_IN*..0]->(:Movie)
RETURN p;
这会产生多条未合并到同一条记录中的路径。虽然可以调用 collect(p),但 Spring Data Neo4j 在映射过程中并不理解路径这一概念。因此,需要从结果中提取节点和关系。
MATCH p=(m:Movie{title: 'The Matrix'})<-[:ACTED_IN]-(:Person)-[:ACTED_IN*..0]->(:Movie)
RETURN m, nodes(p), relationships(p);
由于从《黑客帝国》到另一部电影存在多条路径,结果仍然不会是单条记录。这时就需要用到Cypher 的 reduce 函数。
MATCH p=(m:Movie{title: 'The Matrix'})<-[:ACTED_IN]-(:Person)-[:ACTED_IN*..0]->(:Movie)
WITH collect(p) as paths, m
WITH m,
reduce(a=[], node in reduce(b=[], c in [aa in paths | nodes(aa)] | b + c) | case when node in a then a else a + node end) as nodes,
reduce(d=[], relationship in reduce(e=[], f in [dd in paths | relationships(dd)] | e + f) | case when relationship in d then d else d + relationship end) as relationships
RETURN m, relationships, nodes;
reduce 函数让我们能够将来自各条路径的节点和关系扁平化。最终得到的元组与每个根节点只取一条记录中的类似,但集合中混合了不同的关系类型或节点。
客户端归约
如果归约应在客户端进行,Spring Data Neo4j 也支持映射关系或节点的嵌套列表。但仍然要求返回的记录包含足够的信息,以正确地水合(hydrate)出最终的实体实例。
MATCH p=(m:Movie{title: 'The Matrix'})<-[:ACTED_IN]-(:Person)-[:ACTED_IN*..0]->(:Movie)
RETURN m, collect(nodes(p)), collect(relationships(p));
额外的 collect 语句会创建如下格式的列表:
[[rel1, rel2], [rel3, rel4]]
这些列表会在映射过程中被转换为扁平列表。
选择客户端归约还是数据库端归约,取决于将要产生的数据量。使用 reduce 函数时,所有路径都需要先在数据库内存中创建;而另一方面,大量需要在客户端合并的数据又会带来客户端更高的内存占用。
使用路径填充并返回实体列表
假设有一个如下所示的图:
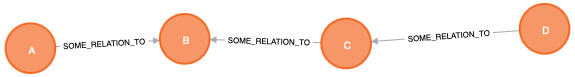
图 2. 带有外向关系的图
以及一个如映射所示的领域模型(为简洁起见,省略了构造函数和访问器):
@Node
public class SomeEntity {

    @Id
    private final Long number;

    private String name;

    @Relationship(type = "SOME_RELATION_TO", direction = Relationship.Direction.OUTGOING)
    private Set<SomeRelation> someRelationsOut = new HashSet<>();

}

@RelationshipProperties
public class SomeRelation {

    @RelationshipId
    private Long id;

    private String someData;

    @TargetNode
    private SomeEntity targetPerson;

}
如您所见,这些关系都是外向的。生成的查找方法(包括 findById)总是会先匹配一个要映射的根节点,然后从该节点出发映射所有相关对象。在只应返回一个对象的查询中,会返回该根对象;在返回多个对象的查询中,会返回所有匹配的对象。这些返回对象的外向和内向关系当然也会被填充。
假设有以下 Cypher 查询:
MATCH p = (leaf:SomeEntity {number: $a})-[:SOME_RELATION_TO*]-(:SomeEntity)
RETURN leaf, collect(nodes(p)), collect(relationships(p))
它遵循了每个根节点只取一条记录中的建议,并且对于您想要匹配的叶子节点效果很好。但是:这仅适用于返回 0 个或 1 个映射对象的场景。虽然该查询会像之前一样填充所有关系,但它不会返回全部 4 个对象。
可以通过返回整条路径来改变这一点:
MATCH p = (leaf:SomeEntity {number: $a})-[:SOME_RELATION_TO*]-(:SomeEntity)
RETURN p
这里我们正是要利用路径 p 实际返回了 3 行、且这些路径覆盖全部 4 个节点这一事实。全部 4 个节点都会被填充、相互链接并返回。
自定义查询中的参数
参数的使用方式与在 Neo4j Browser 或 Cypher-Shell 中执行标准 Cypher 查询时完全相同,使用 $ 语法(从 Neo4j 4.0 起,数据库已移除旧的 ${foo} Cypher 参数语法)。
public interface ARepository extends Neo4jRepository<AnAggregateRoot, String> {

	@Query("MATCH (a:AnAggregateRoot {name: $name}) RETURN a") 1
	Optional<AnAggregateRoot> findByCustomQuery(String name);

}
这里我们按名称引用参数。您也可以改用
$0等形式。
要让命名参数无需额外注解即可生效,您需要使用 -parameters 编译 Java 8+ 项目。Spring Boot 的 Maven 和 Gradle 插件会自动为您完成这一点。如果因某种原因无法这样做,您可以添加 @Param 显式指定名称,或者使用参数索引。
作为参数传递给带有自定义查询注解方法的已映射实体(任何带 @Node 的对象)会被转换为嵌套 Map。以下示例展示了作为 Neo4j 参数的结构。
假设有一个如电影模型所示进行注解的 Movie、Vertex 和 Actor 类:
@Node
public final class Movie {

    @Id
    private final String title;

    @Property("tagline")
    private final String description;

    @Relationship(value = "ACTED_IN", direction = Direction.INCOMING)
    private final List<Actor> actors;

    @Relationship(value = "DIRECTED", direction = Direction.INCOMING)
    private final List<Person> directors;
}

@Node
public final class Person {

    @Id @GeneratedValue
    private final Long id;

    private final String name;

    private Integer born;

    @Relationship("REVIEWED")
    private List<Movie> reviewed = new ArrayList<>();
}

@RelationshipProperties
public final class Actor {

	@RelationshipId
	private final Long id;

    @TargetNode
    private final Person person;

    private final List<String> roles;
}

interface MovieRepository extends Neo4jRepository<Movie, String> {

    @Query("MATCH (m:Movie {title: $movie.__id__})\n"
           + "MATCH (m) <- [r:DIRECTED|REVIEWED|ACTED_IN] - (p:Person)\n"
           + "return m, collect(r), collect(p)")
    Movie findByMovie(@Param("movie") Movie movie);
}
将一个 Movie 实例传给上面的仓库方法,会生成如下 Neo4j Map 参数:
{
  "movie": {
    "__labels__": [
      "Movie"
    ],
    "__id__": "The Da Vinci Code",
    "__properties__": {
      "ACTED_IN": [
        {
          "__properties__": {
            "roles": [
              "Sophie Neveu"
            ]
          },
          "__target__": {
            "__labels__": [
              "Person"
            ],
            "__id__": 402,
            "__properties__": {
              "name": "Audrey Tautou",
              "born": 1976
            }
          }
        },
        {
          "__properties__": {
            "roles": [
              "Sir Leight Teabing"
            ]
          },
          "__target__": {
            "__labels__": [
              "Person"
            ],
            "__id__": 401,
            "__properties__": {
              "name": "Ian McKellen",
              "born": 1939
            }
          }
        },
        {
          "__properties__": {
            "roles": [
              "Dr. Robert Langdon"
            ]
          },
          "__target__": {
            "__labels__": [
              "Person"
            ],
            "__id__": 360,
            "__properties__": {
              "name": "Tom Hanks",
              "born": 1956
            }
          }
        },
        {
          "__properties__": {
            "roles": [
              "Silas"
            ]
          },
          "__target__": {
            "__labels__": [
              "Person"
            ],
            "__id__": 403,
            "__properties__": {
              "name": "Paul Bettany",
              "born": 1971
            }
          }
        }
      ],
      "DIRECTED": [
        {
          "__labels__": [
            "Person"
          ],
          "__id__": 404,
          "__properties__": {
            "name": "Ron Howard",
            "born": 1954
          }
        }
      ],
      "tagline": "Break The Codes",
      "released": 2006
    }
  }
}
节点由一个 Map 表示。该 Map 始终包含 __id__,即被映射的 id 属性;__labels__ 下包含所有静态和动态标签。所有属性——以及关系的类型——都会像实体由 SDN 写入图中时那样出现在这些 Map 里。值会具有正确的 Cypher 类型,无需进一步转换。
所有关系都是 Map 的列表。动态关系会被相应解析。一对一关系也会被序列化为单元素列表。因此,要访问人与人之间的一对一映射,您需要这样写:$person.__properties__.BEST_FRIEND[0].__target__.__id__。
如果一个实体与不同类型的其他节点具有相同类型的关系,它们都会出现在同一个列表中。如果您需要这样的映射,同时又需要处理这些自定义参数,就必须相应地展开它们。一种方式是使用关联子查询(需要 Neo4j 4.1+)。
自定义查询中的值表达式
自定义查询中的 Spring 表达式语言
Spring 表达式语言(SpEL)可以在自定义查询中通过 :#{} 使用。这里的冒号表示参数,此类表达式应用在适合使用参数的位置。不过,当使用我们的字面量扩展时,您可以在标准 Cypher 不允许使用参数的位置(例如标签或关系类型)使用 SpEL 表达式。这是 Spring Data 在查询中定义一段会经过 SpEL 求值的文本块的标准方式。
下面的示例定义了与上面基本相同的查询,但使用 WHERE 子句来避免出现更多花括号:
public interface ARepository extends Neo4jRepository<AnAggregateRoot, String> {

	@Query("MATCH (a:AnAggregateRoot) WHERE a.name = :#{#pt1 + #pt2} RETURN a")
	Optional<AnAggregateRoot> findByCustomQueryWithSpEL(String pt1, String pt2);

}
SpEL 块以 :#{ 开头,然后按名称引用给定的 String 参数(#pt1)。请勿将其与上面的 Cypher 语法混淆!SpEL 表达式会将两个参数拼接为一个值,最终传递给Neo4jClient。SpEL 块以 } 结束。
SpEL 还解决了另外两个问题。我们提供了两个扩展,允许将 Sort 对象传入自定义查询。还记得自定义查询中的Page 与 Slice 示例吗?借助 orderBy 扩展,您可以把带有动态排序的 Pageable 传入自定义查询:
import org.springframework.data.domain.Pageable;
import org.springframework.data.domain.Sort;
import org.springframework.data.neo4j.repository.Neo4jRepository;
import org.springframework.data.neo4j.repository.query.Query;

public interface MyPersonRepository extends Neo4jRepository<Person, Long> {

    @Query(""
        + "MATCH (n:Person) WHERE n.name = $name RETURN n "
        + ":#{orderBy(#pageable)} SKIP $skip LIMIT $limit" 1
    )
    Slice<Person> findSliceByName(String name, Pageable pageable);

    @Query(""
        + "MATCH (n:Person) WHERE n.name = $name RETURN n :#{orderBy(#sort)}" 2
    )
    List<Person> findAllByName(String name, Sort sort);
}
Pageable在 SpEL 上下文中的名称始终为pageable。Sort在 SpEL 上下文中的名称始终为sort。
Spring 表达式语言扩展
字面量扩展
literal 扩展可用于在自定义查询中让标签或关系类型等变为“动态”。Cypher 中标签和关系类型都不能参数化,因此必须以字面量形式给出。
interface BaseClassRepository extends Neo4jRepository<Inheritance.BaseClass, Long> {

    @Query("MATCH (n:`:#{literal(#label)}`) RETURN n") 1
    List<Inheritance.BaseClass> findByLabel(String label);
}
literal扩展会被替换为该参数求值后的字面值。
这里使用 literal 值来动态匹配标签。如果您将 SomeLabel 作为参数传给方法,将生成 MATCH (n:`SomeLabel`) RETURN n。其中添加了反引号以正确转义值。SDN 不会自动替您这样做,因为并非所有情况下这都是您想要的。
列表扩展
对于多个值,有 allOf 和 anyOf 可用,它们会把所有值渲染为用 & 或 | 连接的列表。
interface BaseClassRepository extends Neo4jRepository<Inheritance.BaseClass, Long> {

    @Query("MATCH (n:`:#{allOf(#label)}`) RETURN n")
    List<Inheritance.BaseClass> findByLabels(List<String> labels);

    @Query("MATCH (n:`:#{anyOf(#label)}`) RETURN n")
    List<Inheritance.BaseClass> findByLabels(List<String> labels);
}
引用标签
您已经知道如何将节点映射为领域对象:
@Node(primaryLabel = "Bike", labels = {"Gravel", "Easy Trail"})
public class BikeNode {
    @Id String id;

    String name;
}
这个节点有多个标签,在自定义查询中反复书写它们很容易出错:可能会漏掉一个或拼错。我们提供以下表达式来缓解这个问题:#{#staticLabels}。请注意,它_不_以冒号开头!您可以在带有 @Query 注解的仓库方法上使用它:
public interface BikeRepository extends Neo4jRepository<Bike, String> {

    @Query("MATCH (n:#{#staticLabels}) WHERE n.id = $nameOrId OR n.name = $nameOrId RETURN n")
    Optional<Bike> findByNameOrId(@Param("nameOrId") String nameOrId);
}
该查询将解析为
MATCH (n:`Bike`:`Gravel`:`Easy Trail`) WHERE n.id = $nameOrId OR n.name = $nameOrId RETURN n
请注意,我们对 nameOrId 使用的是普通参数:在大多数情况下,没有必要在此处引入 SpEL 表达式把事情复杂化。
自定义查询中的属性占位符解析
Spring 的属性占位符可以在自定义查询中通过 ${} 使用。
@Query("MATCH (a:AnAggregateRoot) WHERE a.name = :${foo} RETURN a")
Optional<AnAggregateRoot> findByCustomQueryWithPropertyPlaceholder();
在上面的示例中,如果属性 foo 被设置为 bar,那么 ${foo} 块将被解析为 bar。