常见问题(FAQ)
SDN 与 Neo4j-OGM 有什么关系?
Neo4j-OGM 是一个对象图映射库,早期版本的 Spring Data Neo4j 主要将其作为后端,承担将节点和关系映射为领域对象的繁重工作。当前版本的 SDN 不需要也不支持 Neo4j-OGM。SDN 完全使用 Spring Data 的映射上下文来扫描类并构建元模型。
虽然这把 SDN 绑定在了 Spring 生态中,但它也带来了诸多优势,其中包括 CPU 与内存占用更小,尤其是可以使用 Spring 映射上下文的全部特性。
为什么我应该使用 SDN 而不是 SDN+OGM
SDN 具备一些 SDN+OGM 中没有的特性,尤其是
-
完整支持 Spring 的响应式体系,包括响应式事务
-
完整支持按示例查询
-
完整支持完全不可变的实体
-
支持派生查找方法的所有修饰符与变体,包括空间查询
SDN 是否支持通过 HTTP 连接到 Neo4j?
不支持。
SDN 是否支持内嵌的 Neo4j?
内嵌 Neo4j 涉及多个方面:
SDN 是否会为您的应用提供一个内嵌实例?
不提供。
SDN 是否会直接与内嵌实例交互?
不会。内嵌数据库通常由 org.neo4j.graphdb.GraphDatabaseService 的一个实例表示,并且开箱即用时没有 Bolt 连接器。
不过,SDN 可以很好地配合 Neo4j 的测试工具(test harness)使用,该测试工具专门用于作为真实数据库的即插即用替代品。对 Neo4j 3.5、4.x 和 5.x 测试工具的支持是通过驱动的 Spring Boot 起步依赖实现的。请查看对应的模块 org.neo4j.driver:neo4j-java-driver-test-harness-spring-boot-autoconfigure。
可以使用哪个 Neo4j Java 驱动,以及如何使用?
SDN 依赖于 Neo4j Java 驱动。每个 SDN 版本都会使用与其发布时最新可用 Neo4j 兼容的 Neo4j Java 驱动版本。虽然 Neo4j Java 驱动的补丁版本通常可以即插即用,但 SDN 确保即使是次版本号也可以互换,因为它会在必要时检查方法是否存在或接口是否发生变化。
因此,您可以将任意 4.x 版本的 Neo4j Java 驱动与任意 SDN 6.x 版本配合使用,也可以将任意 5.x 版本的 Neo4j 驱动与任意 SDN 7.x 版本配合使用。
使用 Spring Boot 时
如今,基于 Spring Data 的应用最可能采用的部署方式就是 Spring Boot 部署。请使用 Spring Boot 的依赖管理来按如下方式更改驱动版本:
<properties>
  <neo4j-java-driver.version>5.4.0</neo4j-java-driver.version>
</properties>
或者
neo4j-java-driver.version = 5.4.0
不使用 Spring Boot 时
不使用 Spring Boot 时,您只需手动声明依赖。对于 Maven,我们建议像这样使用 <dependencyManagement /> 段:
<dependencyManagement>
    <dependency>
        <groupId>org.neo4j.driver</groupId>
        <artifactId>neo4j-java-driver</artifactId>
        <version>5.4.0</version>
    </dependency>
</dependencyManagement>
Neo4j 4 支持多个数据库——我该如何使用它们?
您既可以静态配置数据库名称,也可以运行自己的数据库名称提供器。请记住,SDN 不会为您创建数据库。您可以借助迁移工具来完成,当然也可以事先用一个简单脚本完成。
静态配置
在您的 Spring Boot 配置中像这样配置要使用的数据库名称(同样的属性当然也适用于基于 YML 或环境变量的配置,并遵循 Spring Boot 的约定):
spring.data.neo4j.database = yourDatabase
配置就绪后,SDN 仓库(包括响应式和命令式)的所有实例以及 ReactiveNeo4jTemplate / Neo4jTemplate 生成的所有查询,都将针对数据库 yourDatabase 执行。
动态配置
根据您 Spring 应用的类型,提供一个类型为 Neo4jDatabaseNameProvider 或 ReactiveDatabaseSelectionProvider 的 Bean。
该 Bean 例如可以使用 Spring 的安全上下文来获取租户。下面是一个经过验证的示例,展示了一个用 Spring Security 保护的命令式应用:
import org.neo4j.springframework.data.core.DatabaseSelection;
import org.neo4j.springframework.data.core.DatabaseSelectionProvider;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.security.core.Authentication;
import org.springframework.security.core.context.SecurityContext;
import org.springframework.security.core.context.SecurityContextHolder;
import org.springframework.security.core.userdetails.User;

@Configuration
public class Neo4jConfig {
	@Bean
	DatabaseSelectionProvider databaseSelectionProvider() {

		return () -> Optional.ofNullable(SecurityContextHolder.getContext())
			.map(SecurityContext::getAuthentication)
			.filter(Authentication::isAuthenticated)
			.map(Authentication::getPrincipal)
			.map(User.class::cast)
			.map(User::getUsername)
			.map(DatabaseSelection::byName)
			.orElseGet(DatabaseSelection::undecided);
	}
}
请注意,不要把从一个数据库检索到的实体与另一个数据库的实体混在一起。数据库名称是在每个新事务开始时请求的,因此如果您在两次调用之间更改数据库名称,最终得到的实体可能比预期少或多。更糟糕的是,您可能不可避免地把错误的实体存进错误的数据库。
Spring Boot 的 Neo4j 健康指标针对的是默认数据库,我该如何更改?
Spring Boot 同时附带命令式和响应式 Neo4j 健康指标。两种变体都能检测应用上下文中多个 org.neo4j.driver.Driver 类型的 Bean,并为每个实例对整体健康状况做出贡献。然而,Neo4j 驱动连接的是一个服务器,而不是该服务器内部的某个具体数据库。Spring Boot 可以在不使用 Spring Data Neo4j 的情况下配置驱动,而要使用哪个数据库这一信息是与 Spring Data Neo4j 绑定的,因此内置的健康指标无法获得该信息。
在很多部署场景中,这很可能不是问题。但是,如果所配置的数据库用户至少没有对默认数据库的访问权限,健康检查将会失败。
可以通过感知数据库选择的自定义 Neo4j 健康贡献者来缓解这一问题。
命令式变体
import java.util.Optional;

import org.neo4j.driver.Driver;
import org.neo4j.driver.Result;
import org.neo4j.driver.SessionConfig;
import org.neo4j.driver.summary.DatabaseInfo;
import org.neo4j.driver.summary.ResultSummary;
import org.neo4j.driver.summary.ServerInfo;
import org.springframework.boot.actuate.health.AbstractHealthIndicator;
import org.springframework.boot.actuate.health.Health;
import org.springframework.data.neo4j.core.DatabaseSelection;
import org.springframework.data.neo4j.core.DatabaseSelectionProvider;
import org.springframework.util.StringUtils;

public class DatabaseSelectionAwareNeo4jHealthIndicator extends AbstractHealthIndicator {

    private final Driver driver;

    private final DatabaseSelectionProvider databaseSelectionProvider;

    public DatabaseSelectionAwareNeo4jHealthIndicator(
        Driver driver, DatabaseSelectionProvider databaseSelectionProvider
    ) {
        this.driver = driver;
        this.databaseSelectionProvider = databaseSelectionProvider;
    }

    @Override
    protected void doHealthCheck(Health.Builder builder) {
        try {
            SessionConfig sessionConfig = Optional
                .ofNullable(databaseSelectionProvider.getDatabaseSelection())
                .filter(databaseSelection -> databaseSelection != DatabaseSelection.undecided())
                .map(DatabaseSelection::getValue)
                .map(v -> SessionConfig.builder().withDatabase(v).build())
                .orElseGet(SessionConfig::defaultConfig);

            class Tuple {
                String edition;
                ResultSummary resultSummary;

                Tuple(String edition, ResultSummary resultSummary) {
                    this.edition = edition;
                    this.resultSummary = resultSummary;
                }
            }

            String query =
                "CALL dbms.components() YIELD name, edition WHERE name = 'Neo4j Kernel' RETURN edition";
            Tuple health = driver.session(sessionConfig)
                .writeTransaction(tx -> {
                    Result result = tx.run(query);
                    String edition = result.single().get("edition").asString();
                    return new Tuple(edition, result.consume());
                });

            addHealthDetails(builder, health.edition, health.resultSummary);
        } catch (Exception ex) {
            builder.down().withException(ex);
        }
    }

    static void addHealthDetails(Health.Builder builder, String edition, ResultSummary resultSummary) {
        ServerInfo serverInfo = resultSummary.server();
        builder.up()
            .withDetail(
                "server", serverInfo.version() + "@" + serverInfo.address())
            .withDetail("edition", edition);
        DatabaseInfo databaseInfo = resultSummary.database();
        if (StringUtils.hasText(databaseInfo.name())) {
            builder.withDetail("database", databaseInfo.name());
        }
    }
}
这会使用可用的数据库选择,运行与 Boot 检查连接是否健康时相同的查询。使用以下配置来应用它:
import java.util.Map;

import org.neo4j.driver.Driver;
import org.springframework.beans.factory.InitializingBean;
import org.springframework.boot.actuate.health.CompositeHealthContributor;
import org.springframework.boot.actuate.health.HealthContributor;
import org.springframework.boot.actuate.health.HealthContributorRegistry;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.data.neo4j.core.DatabaseSelectionProvider;

@Configuration(proxyBeanMethods = false)
public class Neo4jHealthConfig {

    @Bean 1
    DatabaseSelectionAwareNeo4jHealthIndicator databaseSelectionAwareNeo4jHealthIndicator(
        Driver driver, DatabaseSelectionProvider databaseSelectionProvider
    ) {
        return new DatabaseSelectionAwareNeo4jHealthIndicator(driver, databaseSelectionProvider);
    }

    @Bean 2
    HealthContributor neo4jHealthIndicator(
        Map<String, DatabaseSelectionAwareNeo4jHealthIndicator> customNeo4jHealthIndicators) {
        return CompositeHealthContributor.fromMap(customNeo4jHealthIndicators);
    }

    @Bean 3
    InitializingBean healthContributorRegistryCleaner(
        HealthContributorRegistry healthContributorRegistry,
        Map<String, DatabaseSelectionAwareNeo4jHealthIndicator> customNeo4jHealthIndicators
    ) {
        return () -> customNeo4jHealthIndicators.keySet()
            .stream()
            .map(HealthContributorNameFactory.INSTANCE)
            .forEach(healthContributorRegistry::unregisterContributor);
    }
}
如果您有多个驱动和数据库选择提供器,则需要为每种组合创建一个指标
这确保所有这些指标都被分组到 Neo4j 之下,替换默认的 Neo4j 健康指标
这防止各个贡献者直接出现在健康端点中
响应式变体
响应式变体基本相同,只是使用响应式类型和相应的响应式基础设施类:
import reactor.core.publisher.Mono;
import reactor.util.function.Tuple2;

import org.neo4j.driver.Driver;
import org.neo4j.driver.SessionConfig;
import org.neo4j.driver.reactivestreams.RxResult;
import org.neo4j.driver.reactivestreams.RxSession;
import org.neo4j.driver.summary.DatabaseInfo;
import org.neo4j.driver.summary.ResultSummary;
import org.neo4j.driver.summary.ServerInfo;
import org.reactivestreams.Publisher;
import org.springframework.boot.actuate.health.AbstractReactiveHealthIndicator;
import org.springframework.boot.actuate.health.Health;
import org.springframework.data.neo4j.core.DatabaseSelection;
import org.springframework.data.neo4j.core.ReactiveDatabaseSelectionProvider;
import org.springframework.util.StringUtils;

public final class DatabaseSelectionAwareNeo4jReactiveHealthIndicator
    extends AbstractReactiveHealthIndicator {

    private final Driver driver;

    private final ReactiveDatabaseSelectionProvider databaseSelectionProvider;

    public DatabaseSelectionAwareNeo4jReactiveHealthIndicator(
        Driver driver,
        ReactiveDatabaseSelectionProvider databaseSelectionProvider
    ) {
        this.driver = driver;
        this.databaseSelectionProvider = databaseSelectionProvider;
    }

    @Override
    protected Mono<Health> doHealthCheck(Health.Builder builder) {
        String query =
            "CALL dbms.components() YIELD name, edition WHERE name = 'Neo4j Kernel' RETURN edition";
        return databaseSelectionProvider.getDatabaseSelection()
            .map(databaseSelection -> databaseSelection == DatabaseSelection.undecided() ?
                SessionConfig.defaultConfig() :
                SessionConfig.builder().withDatabase(databaseSelection.getValue()).build()
            )
            .flatMap(sessionConfig ->
                Mono.usingWhen(
                    Mono.fromSupplier(() -> driver.rxSession(sessionConfig)),
                    s -> {
                        Publisher<Tuple2<String, ResultSummary>> f = s.readTransaction(tx -> {
                            RxResult result = tx.run(query);
                            return Mono.from(result.records())
                                .map((record) -> record.get("edition").asString())
                                .zipWhen((edition) -> Mono.from(result.consume()));
                        });
                        return Mono.fromDirect(f);
                    },
                    RxSession::close
                )
            ).map((result) -> {
                addHealthDetails(builder, result.getT1(), result.getT2());
                return builder.build();
            });
    }

    static void addHealthDetails(Health.Builder builder, String edition, ResultSummary resultSummary) {
        ServerInfo serverInfo = resultSummary.server();
        builder.up()
            .withDetail(
                "server", serverInfo.version() + "@" + serverInfo.address())
            .withDetail("edition", edition);
        DatabaseInfo databaseInfo = resultSummary.database();
        if (StringUtils.hasText(databaseInfo.name())) {
            builder.withDetail("database", databaseInfo.name());
        }
    }
}
当然还有配置的响应式变体。它需要两个不同的注册表清理器,因为 Spring Boot 会把现有的响应式指标包装起来,以便也能与非响应式 actuator 端点一起使用。
import java.util.Map;

import org.springframework.beans.factory.InitializingBean;
import org.springframework.boot.actuate.health.CompositeReactiveHealthContributor;
import org.springframework.boot.actuate.health.HealthContributorNameFactory;
import org.springframework.boot.actuate.health.HealthContributorRegistry;
import org.springframework.boot.actuate.health.ReactiveHealthContributor;
import org.springframework.boot.actuate.health.ReactiveHealthContributorRegistry;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration(proxyBeanMethods = false)
public class Neo4jHealthConfig {

    @Bean
    ReactiveHealthContributor neo4jHealthIndicator(
        Map<String, DatabaseSelectionAwareNeo4jReactiveHealthIndicator> customNeo4jHealthIndicators) {
        return CompositeReactiveHealthContributor.fromMap(customNeo4jHealthIndicators);
    }

    @Bean
    InitializingBean healthContributorRegistryCleaner(HealthContributorRegistry healthContributorRegistry,
        Map<String, DatabaseSelectionAwareNeo4jReactiveHealthIndicator> customNeo4jHealthIndicators) {
        return () -> customNeo4jHealthIndicators.keySet()
            .stream()
            .map(HealthContributorNameFactory.INSTANCE)
            .forEach(healthContributorRegistry::unregisterContributor);
    }

    @Bean
    InitializingBean reactiveHealthContributorRegistryCleaner(
        ReactiveHealthContributorRegistry healthContributorRegistry,
        Map<String, DatabaseSelectionAwareNeo4jReactiveHealthIndicator> customNeo4jHealthIndicators) {
        return () -> customNeo4jHealthIndicators.keySet()
            .stream()
            .map(HealthContributorNameFactory.INSTANCE)
            .forEach(healthContributorRegistry::unregisterContributor);
    }
}
Neo4j 4.4+ 支持模拟不同用户——我该如何使用?
用户模拟在大型多租户场景中尤其有用:在这种场景下,一个物理连接(或技术)用户可以模拟多个租户。根据您的具体设置,这将大幅减少所需的物理驱动实例数量。
该功能要求服务器端为 Neo4j Enterprise 4.4+,客户端为 4.4+ 驱动(org.neo4j.driver:neo4j-java-driver:4.4.0 或更高版本)。
对于命令式和响应式两种版本,您都需要提供一个 UserSelectionProvider 或对应的 ReactiveUserSelectionProvider。同一个实例需要传递给 Neo4Client 与 Neo4jTransactionManager,或它们的响应式变体。
在无 Boot 的命令式配置和响应式配置中,您只需提供一个相关类型的 Bean:
import org.springframework.data.neo4j.core.UserSelection;
import org.springframework.data.neo4j.core.UserSelectionProvider;

public class CustomConfig {

    @Bean
    public UserSelectionProvider getUserSelectionProvider() {
        return () -> UserSelection.impersonate("someUser");
    }
}
在典型的 Spring Boot 场景中,该功能需要多做一些工作,因为 Boot 也要支持不具备该功能的 SDN 版本。因此,对于用户选择提供器 Bean中的那个 Bean,您需要完全自定义客户端和事务管理器:
import org.neo4j.driver.Driver;

import org.springframework.data.neo4j.core.DatabaseSelectionProvider;
import org.springframework.data.neo4j.core.Neo4jClient;
import org.springframework.data.neo4j.core.UserSelectionProvider;
import org.springframework.data.neo4j.core.transaction.Neo4jTransactionManager;

import org.springframework.transaction.PlatformTransactionManager;

public class CustomConfig {

    @Bean
    public Neo4jClient neo4jClient(
        Driver driver,
        DatabaseSelectionProvider databaseSelectionProvider,
        UserSelectionProvider userSelectionProvider
    ) {

        return Neo4jClient.with(driver)
            .withDatabaseSelectionProvider(databaseSelectionProvider)
            .withUserSelectionProvider(userSelectionProvider)
            .build();
	}

    @Bean
    public PlatformTransactionManager transactionManager(
        Driver driver,
        DatabaseSelectionProvider databaseSelectionProvider,
        UserSelectionProvider userSelectionProvider
    ) {

        return Neo4jTransactionManager
            .with(driver)
            .withDatabaseSelectionProvider(databaseSelectionProvider)
            .withUserSelectionProvider(userSelectionProvider)
            .build();
	}
}
从 Spring Data Neo4j 使用 Neo4j 集群实例
以下问题既适用于 Neo4j AuraDB,也适用于本地部署的 Neo4j 集群实例。
我是否需要特殊配置,才能让事务在 Neo4j 因果集群中无缝工作?
不需要。SDN 在内部使用 Neo4j 因果集群书签,无需您做任何配置。同一线程中或同一响应式流中先后执行的事务,将能够如您所预期那样读取到先前更改的值。
对 Neo4j 集群使用只读事务重要吗?
重要。Neo4j 集群架构是一种因果集群架构,它区分主服务器和从服务器。主服务器既可以是单实例,也可以是核心实例。两者都能响应读操作和写操作。写操作会从核心实例传播到集群内的只读副本,或者更一般地说,传播到跟随者(follower)。这些跟随者就是从服务器。从服务器不响应写操作。
在标准部署场景中,集群内会有若干核心实例和许多只读副本。因此,将操作或查询标记为只读非常重要,这样才能以一种不会压垮领导者、并尽可能把查询传播到只读副本的方式扩展集群。
Spring Data Neo4j 和底层 Java 驱动都不会做 Cypher 解析,这两个构建块默认都假定操作是写操作。之所以这样设计,是为了开箱即用地支持所有操作。如果技术栈在默认情况下假定是只读的,那么它最终可能会把写查询发到只读副本并在执行时失败。
所有 findById、findAllById、findAll 以及预定义的存在性方法默认都被标记为只读。
下面介绍一些可选方案:
import org.springframework.data.neo4j.repository.Neo4jRepository;
import org.springframework.transaction.annotation.Transactional;

@Transactional(readOnly = true)
interface PersonRepository extends Neo4jRepository<Person, Long> {
}
import org.springframework.data.neo4j.repository.Neo4jRepository;
import org.springframework.data.neo4j.repository.query.Query;
import org.springframework.transaction.annotation.Transactional;

interface PersonRepository extends Neo4jRepository<Person, Long> {

  @Transactional(readOnly = true)
  Person findOneByName(String name); 1

  @Transactional(readOnly = true)
  @Query("""
    CALL apoc.search.nodeAll('{Person: "name",Movie: ["title","tagline"]}','contains','her')
    YIELD node AS n RETURN n""")
  Person findByCustomQuery(); 2
}
为什么它默认不是只读的?虽然对上面那个派生查找方法(我们确实知道它是只读的)这样做没问题,但我们经常见到这样的情况:用户添加了一个自定义
@Query,却用MERGE结构来实现它,而这当然是一个写操作。自定义存储过程可以做各种各样的事情,目前我们无法在此判断它是只读还是写。
import java.util.Optional;

import org.springframework.data.neo4j.repository.Neo4jRepository;
import org.springframework.transaction.annotation.Transactional;

interface PersonRepository extends Neo4jRepository<Person, Long> {
}

interface MovieRepository extends Neo4jRepository<Movie, Long> {
  List<Movie> findByLikedByPersonName(String name);
}

public class PersonService {

  private final PersonRepository personRepository;
  private final MovieRepository movieRepository;

  public PersonService(PersonRepository personRepository,
        MovieRepository movieRepository) {
    this.personRepository = personRepository;
    this.movieRepository = movieRepository;
  }

  @Transactional(readOnly = true)
  public Optional<PersonDetails> getPerson(Long id) { 1
    return this.repository.findById(id)
      .map(person -> {
        var movies = this.movieRepository
          .findByLikedByPersonName(person.getName());
        return new PersonDetails(person, movies);
            });
    }
}
这里,对多个仓库的多次调用被包装在一个单一的只读事务中。
import java.util.Collection;

import org.neo4j.driver.types.Node;
import org.springframework.data.neo4j.core.Neo4jClient;
import org.springframework.transaction.PlatformTransactionManager;
import org.springframework.transaction.TransactionDefinition;
import org.springframework.transaction.support.TransactionTemplate;

public class PersonService {

  private final TransactionTemplate readOnlyTx;

  private final Neo4jClient neo4jClient;

  public PersonService(PlatformTransactionManager transactionManager, Neo4jClient neo4jClient) {

    this.readOnlyTx = new TransactionTemplate(transactionManager, 1
        new TransactionDefinition() {
          @Override public boolean isReadOnly() {
            return true;
          }
        }
    );
    this.neo4jClient = neo4jClient;
  }

  void internalOperation() { 2

    Collection<Node> nodes = this.readOnlyTx.execute(state -> {
      return neo4jClient.query("MATCH (n) RETURN n").fetchAs(Node.class) 3
          .mappedBy((types, record) -> record.get(0).asNode())
          .all();
    });
  }
}
根据您所需的特性创建一个
TransactionTemplate实例。当然,它也可以是一个全局 Bean。使用事务模板的首要原因:声明式事务无法在包私有或私有方法中生效,也无法在内部方法调用中生效(设想一下本服务中另一个方法调用
internalOperation的情形),这是因为它们本质上是用切面和代理实现的。Neo4jClient是 SDN 提供的一个固定工具。它不能被加注解,但与 Spring 集成。因此,它为您提供了使用纯驱动时所能做的一切,只不过带自动映射和事务。它也遵循声明式事务。
我可以获取最新的书签,或者为事务管理器播种书签吗?
正如书签管理中简要提到的那样,关于书签您无需配置任何东西。不过,获取 SDN 事务系统从数据库接收到的最新书签可能会很有用。您可以添加一个像 BookmarkCapture 这样的 @Bean 来做到这一点:
import java.util.Set;

import org.neo4j.driver.Bookmark;
import org.springframework.context.ApplicationListener;

public final class BookmarkCapture
    implements ApplicationListener<Neo4jBookmarksUpdatedEvent> {

    @Override
    public void onApplicationEvent(Neo4jBookmarksUpdatedEvent event) {
        // We make sure that this event is called only once,
        // the thread safe application of those bookmarks is up to your system.
        Set<Bookmark> latestBookmarks = event.getBookmarks();
    }
}
要为事务系统播种书签,需要一个如下所示的自定义事务管理器:
import java.util.Set;
import java.util.function.Supplier;

import org.neo4j.driver.Bookmark;
import org.neo4j.driver.Driver;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.data.neo4j.core.DatabaseSelectionProvider;
import org.springframework.data.neo4j.core.transaction.Neo4jBookmarkManager;
import org.springframework.data.neo4j.core.transaction.Neo4jTransactionManager;
import org.springframework.transaction.PlatformTransactionManager;

@Configuration
public class BookmarkSeedingConfig {

    @Bean
    public PlatformTransactionManager transactionManager(
            Driver driver, DatabaseSelectionProvider databaseNameProvider) { 1

        Supplier<Set<Bookmark>> bookmarkSupplier = () -> { 2
            Bookmark a = null;
            Bookmark b = null;
            return Set.of(a, b);
        };

        Neo4jBookmarkManager bookmarkManager =
            Neo4jBookmarkManager.create(bookmarkSupplier); 3
        return new Neo4jTransactionManager(
            driver, databaseNameProvider, bookmarkManager); 4
    }
}
让 Spring 注入这些
这个提供器可以是任何持有您想带入系统的最新书签的东西
用它创建书签管理器
把它传递给自定义事务管理器
除非您的应用确实需要访问或提供这些数据,否则没有必要做上面任何一件事。如果拿不准,就两者都不要做。
我可以禁用书签管理吗?
我们提供了一个 Noop 书签管理器,它会有效地禁用书签管理。
使用此书签管理器风险自负:它会丢弃所有书签且永不提供任何书签,从而有效地禁用一切书签管理。在集群中,您将面临很高的读到过期数据(stale read)的风险。在单实例下,它很可能不会产生任何影响。
+ 在集群中,只有在您能够容忍过期读取、且不会面临覆盖旧数据的风险时,这才是一种合理的做法。
以下配置会创建一个书签管理器的 "noop" 变体,它会被相关类自动拾取。
import org.neo4j.driver.Driver;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.data.neo4j.core.transaction.Neo4jBookmarkManager;

@Configuration
public class BookmarksDisabledConfig {

    @Bean
    public Neo4jBookmarkManager neo4jBookmarkManager() {

        return Neo4jBookmarkManager.noop();
    }
}
您可以分别配置 Neo4jTransactionManager/Neo4jClient 和 ReactiveNeo4jTransactionManager/ReactiveNeo4jClient 这两对组合,但我们建议仅当您已经为特定数据库选择需求而配置它们时才这样做。
我需要使用 Neo4j 专有的注解吗?
不需要。您可以自由使用以下等效的 Spring Data 通用注解:
| SDN 专有注解 | Spring Data 通用注解 | 用途 | 区别 |
|---|---|---|---|
org.springframework.data.neo4j.core.schema.Id | org.springframework.data.annotation.Id | 将被注解的属性标记为唯一 ID。 | 专有注解没有额外特性。 |
org.springframework.data.neo4j.core.schema.Node | org.springframework.data.annotation.Persistent | 将类标记为持久化实体。 | @Node 允许自定义标签 |
如何使用分配式 ID?
只需使用不带 @GeneratedValue 的 @Id,并通过构造函数参数、setter 或 wither 来填充您的 id 属性。有关如何寻找好 ID 的一些一般性论述,请参阅这篇博客文章。
如何使用外部生成的 ID?
我们提供了接口 org.springframework.data.neo4j.core.schema.IdGenerator。您可以按任意方式实现它,并像这样配置您的实现:
@Node
public class ThingWithGeneratedId {

	@Id @GeneratedValue(TestSequenceGenerator.class)
	private String theId;
}
如果您把一个类的名称传给 @GeneratedValue,那么该类必须有一个无参默认构造函数。不过,您也可以使用一个字符串:
@Node
public class ThingWithIdGeneratedByBean {

	@Id @GeneratedValue(generatorRef = "idGeneratingBean")
	private String theId;
}
这样,idGeneratingBean 就指向 Spring 上下文中的一个 Bean。这对于生成序列可能很有用。
id 的非 final 字段不需要 setter。
我必须为每个领域类都创建仓库吗?
不必。请查看 SDN 构建块,找到 Neo4jTemplate 或 ReactiveNeo4jTemplate。
这些模板了解您的领域,并提供检索、写入和计数实体所需的全部基本 CRUD 方法。
下面是我们经典的电影示例,使用命令式模板:
import java.util.Collections;
import java.util.Optional;

import org.junit.jupiter.api.Test;

import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.autoconfigure.data.neo4j.DataNeo4jTest;
import org.springframework.data.neo4j.core.Neo4jTemplate;
import org.springframework.data.neo4j.documentation.domain.MovieEntity;
import org.springframework.data.neo4j.documentation.domain.PersonEntity;
import org.springframework.data.neo4j.documentation.domain.Roles;
import org.springframework.data.neo4j.test.Neo4jIntegrationTest;

import static org.assertj.core.api.Assertions.assertThat;

@Neo4jIntegrationTest
@DataNeo4jTest
public class TemplateExampleTest {

	@Test
	void shouldSaveAndReadEntities(@Autowired Neo4jTemplate neo4jTemplate) {

		MovieEntity movie = new MovieEntity("The Love Bug",
				"A movie that follows the adventures of Herbie, Herbie's driver, "
						+ "Jim Douglas (Dean Jones), and Jim's love interest, " + "Carole Bennett (Michele Lee)");

		Roles roles1 = new Roles(new PersonEntity(1931, "Dean Jones"), Collections.singletonList("Didi"));
		Roles roles2 = new Roles(new PersonEntity(1942, "Michele Lee"), Collections.singletonList("Michi"));
		movie.getActorsAndRoles().add(roles1);
		movie.getActorsAndRoles().add(roles2);

		MovieEntity result = neo4jTemplate.save(movie);
		assertThat(result.getActorsAndRoles()).allSatisfy(relationship -> assertThat(relationship.getId()).isNotNull());

		Optional<PersonEntity> person = neo4jTemplate.findById("Dean Jones", PersonEntity.class);
		assertThat(person).map(PersonEntity::getBorn).hasValue(1931);

		assertThat(neo4jTemplate.count(PersonEntity.class)).isEqualTo(2L);
	}

}
下面是响应式版本,为简洁起见省略了初始化设置:
import java.util.Collections;

import org.junit.jupiter.api.Test;
import org.testcontainers.neo4j.Neo4jContainer;
import org.testcontainers.junit.jupiter.Container;
import org.testcontainers.junit.jupiter.Testcontainers;
import reactor.test.StepVerifier;

import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.autoconfigure.data.neo4j.DataNeo4jTest;
import org.springframework.data.neo4j.core.ReactiveNeo4jTemplate;
import org.springframework.data.neo4j.documentation.domain.MovieEntity;
import org.springframework.data.neo4j.documentation.domain.PersonEntity;
import org.springframework.data.neo4j.documentation.domain.Roles;
import org.springframework.test.context.DynamicPropertyRegistry;
import org.springframework.test.context.DynamicPropertySource;

@Testcontainers
@DataNeo4jTest
class ReactiveTemplateExampleTest {

	@Container
	private static Neo4jContainer neo4jContainer = new Neo4jContainer("neo4j:5");

	@DynamicPropertySource
	static void neo4jProperties(DynamicPropertyRegistry registry) {
		registry.add("org.neo4j.driver.uri", neo4jContainer::getBoltUrl);
		registry.add("org.neo4j.driver.authentication.username", () -> "neo4j");
		registry.add("org.neo4j.driver.authentication.password", neo4jContainer::getAdminPassword);
	}

	@Test
	void shouldSaveAndReadEntities(@Autowired ReactiveNeo4jTemplate neo4jTemplate) {

		MovieEntity movie = new MovieEntity("The Love Bug",
				"A movie that follows the adventures of Herbie, Herbie's driver, Jim Douglas (Dean Jones), and Jim's love interest, Carole Bennett (Michele Lee)");

		Roles role1 = new Roles(new PersonEntity(1931, "Dean Jones"), Collections.singletonList("Didi"));
		Roles role2 = new Roles(new PersonEntity(1942, "Michele Lee"), Collections.singletonList("Michi"));
		movie.getActorsAndRoles().add(role1);
		movie.getActorsAndRoles().add(role2);

		StepVerifier.create(neo4jTemplate.save(movie)).expectNextCount(1L).verifyComplete();

		StepVerifier.create(neo4jTemplate.findById("Dean Jones", PersonEntity.class).map(PersonEntity::getBorn))
			.expectNext(1931)
			.verifyComplete();

		StepVerifier.create(neo4jTemplate.count(PersonEntity.class)).expectNext(2L).verifyComplete();
	}

}
请注意,这两个示例都使用了 Spring Boot 提供的 @DataNeo4jTest。
如何在返回 Page<T> 或 Slice<T> 的仓库方法中使用自定义查询?
对于返回 Page<T> 或 Slice<T> 的派生查找方法,您除了提供一个 Pageable 参数外无需提供任何其他内容;但对于自定义查询,您必须让它能够处理 pageable。页与切片为您概述了所需的内容。
import org.springframework.data.domain.Pageable;
import org.springframework.data.neo4j.repository.Neo4jRepository;
import org.springframework.data.neo4j.repository.query.Query;

public interface MyPersonRepository extends Neo4jRepository<Person, Long> {

    Page<Person> findByName(String name, Pageable pageable); 1

    @Query(""
        + "MATCH (n:Person) WHERE n.name = $name RETURN n "
        + "ORDER BY n.name ASC SKIP $skip LIMIT $limit"
    )
    Slice<Person> findSliceByName(String name, Pageable pageable); 2

    @Query(
    	value = ""
            + "MATCH (n:Person) WHERE n.name = $name RETURN n "
            + "ORDER BY n.name ASC SKIP $skip LIMIT $limit",
        countQuery = ""
            + "MATCH (n:Person) WHERE n.name = $name RETURN count(n)"
    )
    Page<Person> findPageByName(String name, Pageable pageable); 3
}
一个为您创建查询的派生查找方法。它会替您处理
Pageable。您应该使用一个带排序的 pageable。该方法使用
@Query定义一个自定义查询。它返回一个Slice<Person>。切片不知道总页数,因此自定义查询不需要专门的计数查询。SDN 会通知您它是在估计下一个切片。Cypher 模板必须同时识别$skip和$limit这两个 Cypher 参数。如果您省略它们,SDN 会发出警告。其结果很可能不符合您的预期。此外,Pageable应该是未排序的,并且您应提供一个稳定的排序顺序。我们不会使用 pageable 中的排序信息。该方法返回一个页。页知道总页数的确切数量。因此,您必须指定一个额外的计数查询。第二个方法的所有其他限制在此同样适用。
我可以映射命名路径吗?
一系列相连的节点和关系在 Neo4j 中被称为「路径」。Cypher 允许用一个标识符为路径命名,如下例所示:
p = (a)-[*3..5]->(b)
或者,就像那个著名的电影图(Movie graph)所包含的路径那样(在本例中,是两位演员之间的最短路径之一):
MATCH p=shortestPath((bacon:Person {name:"Kevin Bacon"})-[*]-(meg:Person {name:"Meg Ryan"}))
RETURN p
它看起来像这样:
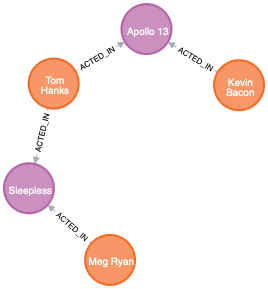
我们发现了 3 个标签为 Vertex 的节点和 2 个标签为 Movie 的节点。两者都可以用自定义查询来映射。假设 Vertex 和 Movie 都有一个节点实体,并且还有一个 Actor 负责处理关系:
@Node
public final class Person {

	@Id @GeneratedValue
	private final Long id;

	private final String name;

	private Integer born;

	@Relationship("REVIEWED")
	private List<Movie> reviewed = new ArrayList<>();
}

@RelationshipProperties
public final class Actor {

	@RelationshipId
	private final Long id;

	@TargetNode
	private final Person person;

	private final List<String> roles;
}

@Node
public final class Movie {

	@Id
	private final String title;

	@Property("tagline")
	private final String description;

	@Relationship(value = "ACTED_IN", direction = Direction.INCOMING)
	private final List<Actor> actors;
}
当对 Vertex 类型的领域类使用如「Bacon」距离所示的查询时,像这样
interface PeopleRepository extends Neo4jRepository<Person, Long> {
    @Query(""
        + "MATCH p=shortestPath((bacon:Person {name: $person1})-[*]-(meg:Person {name: $person2}))\n"
        + "RETURN p"
    )
    List<Person> findAllOnShortestPathBetween(@Param("person1") String person1, @Param("person2") String person2);
}
它会从路径中检索所有人物并映射它们。如果路径上存在领域中也有的关系类型(如 REVIEWED),这些关系将根据路径相应地填充。
当您使用基于路径查询所水合(hydrate)的节点来保存数据时,请格外小心。如果并非所有关系都被水合,数据将会丢失。
反过来也同样可行。同一个查询可以与 Movie 实体一起使用。这样它就只会填充电影。下面的清单展示了如何做到这一点,以及如何用路径上找不到的额外数据来丰富查询。这些数据用于正确填充缺失的关系(在本例中,是所有演员)。
interface MovieRepository extends Neo4jRepository<Movie, String> {

    @Query(""
        + "MATCH p=shortestPath(\n"
        + "(bacon:Person {name: $person1})-[*]-(meg:Person {name: $person2}))\n"
        + "WITH p, [n IN nodes(p) WHERE n:Movie] AS x\n"
        + "UNWIND x AS m\n"
        + "MATCH (m) <-[r:DIRECTED]-(d:Person)\n"
        + "RETURN p, collect(r), collect(d)"
    )
    List<Movie> findAllOnShortestPathBetween(@Param("person1") String person1, @Param("person2") String person2);
}
该查询返回路径,以及为使电影实体完全水合而收集到的所有关系和相关节点。
路径映射既适用于单条路径,也适用于多条路径记录(由 allShortestPath 函数返回)。
命名路径可以高效地用于填充并返回不止一个根节点,请参阅 appendix/custom-queries.adoc#custom-query.paths。
@Query 是使用自定义查询的唯一方式吗?
不是,@Query 不是运行自定义查询的唯一方式。当您的自定义查询能完整填充领域模型时,这个注解用起来很方便。请记住,SDN 假定您映射的领域模型就是真相。这意味着,如果您通过 @Query 使用一个只部分填充模型的自定义查询,那么您就有可能用同一个对象把数据写回去,最终将会擦除或覆盖您在查询中没有考虑到的数据。
因此,凡是在查询结果形状与您的领域模型一致、或者您确定不会把部分映射的模型用于写命令的情况下,请使用仓库和带 @Query 的声明式方法。
有哪些替代方案?
-
投影可能已经足以塑造您对图的视图:它们可以用来显式定义获取属性和相关实体的深度:通过对它们建模。
-
如果您的目标只是让查询的条件变为动态的,那么请查看 QuerydslPredicateExecutor,尤其是我们自己的变体
CypherdslConditionExecutor。这两个混入(mixin)都允许为我们为您创建的完整查询添加条件。这样,您就能在完整填充领域的同时带上自定义条件。当然,您的条件必须与我们生成的内容相配合。根节点、相关节点等的名称请见此处。 -
通过
CypherdslStatementExecutor或ReactiveCypherdslStatementExecutor使用 Cypher-DSL。Cypher-DSL 天生就适合创建动态查询。说到底,这本来就是 SDN 在底层使用的东西。相应的混入既可以用于仓库本身的领域类型,也可以用于投影(这是用于添加条件的混入所做不到的)。
如果您认为可以用一个部分动态查询、或一个完整动态查询加上投影来解决问题,那么请现在跳回关于 Spring Data Neo4j 混入的那一章。
为什么现在要谈自定义仓库片段?
-
您可能遇到更复杂的情况,需要不止一个动态查询,但这些查询在概念上仍属于某个仓库,而不是服务层
-
您的自定义查询返回的是一种图形状的结果,它与您的领域模型不太吻合,因此自定义查询还应伴随一个自定义映射
-
您需要与驱动交互,例如进行不应经过对象映射的批量加载。
假设如下这个仓库_声明_,它基本上聚合了一个基础仓库加上 3 个片段:
import org.springframework.data.neo4j.documentation.domain.MovieEntity;
import org.springframework.data.neo4j.repository.Neo4jRepository;

public interface MovieRepository
        extends Neo4jRepository<MovieEntity, String>, DomainResults, NonDomainResults, LowlevelInteractions {

}
该仓库所扩展的附加接口(DomainResults、NonDomainResults 和 LowlevelInteractions)就是用来解决上述所有问题的片段。
使用复杂、动态的自定义查询,但仍返回领域类型
片段 DomainResults 声明了一个附加方法 findMoviesAlongShortestPath:
import java.util.List;

import org.springframework.data.neo4j.documentation.domain.MovieEntity;
import org.springframework.data.neo4j.documentation.domain.PersonEntity;
import org.springframework.transaction.annotation.Transactional;

interface DomainResults {

    @Transactional(readOnly = true)
    List<MovieEntity> findMoviesAlongShortestPath(PersonEntity from, PersonEntity to);

}
该方法标注了 @Transactional(readOnly = true),以指示读取者可以处理它。它无法由 SDN 派生,而需要一个自定义查询。这个自定义查询由该接口的唯一实现提供。该实现同名,只是后缀为 Impl:
import java.util.HashMap;
import java.util.List;
import java.util.Map;

import org.neo4j.cypherdsl.core.Cypher;

import org.springframework.data.neo4j.core.Neo4jTemplate;
import org.springframework.data.neo4j.documentation.domain.MovieEntity;
import org.springframework.data.neo4j.documentation.domain.PersonEntity;

import static org.neo4j.cypherdsl.core.Cypher.anyNode;
import static org.neo4j.cypherdsl.core.Cypher.listWith;
import static org.neo4j.cypherdsl.core.Cypher.name;
import static org.neo4j.cypherdsl.core.Cypher.node;
import static org.neo4j.cypherdsl.core.Cypher.parameter;

class DomainResultsImpl implements DomainResults {

    private final Neo4jTemplate neo4jTemplate; 1

    DomainResultsImpl(Neo4jTemplate neo4jTemplate) {
        this.neo4jTemplate = neo4jTemplate;
    }

    @Override
    public List<MovieEntity> findMoviesAlongShortestPath(PersonEntity from, PersonEntity to) {

        var p1 = node("Person").withProperties("name", parameter("person1"));
        var p2 = node("Person").withProperties("name", parameter("person2"));
        var shortestPath = Cypher.shortestK(1).named("p").definedBy(p1.relationshipBetween(p2).unbounded());
        var p = shortestPath.getRequiredSymbolicName();
        var statement = Cypher.match(shortestPath)
            .with(p, listWith(name("n")).in(Cypher.nodes(shortestPath))
                .where(anyNode().named("n").hasLabels("Movie"))
                .returning()
                .as("mn"))
            .unwind(name("mn"))
            .as("m")
            .with(p, name("m"))
            .match(node("Person").named("d").relationshipTo(anyNode("m"), "DIRECTED").named("r"))
            .returning(p, Cypher.collect(name("r")), Cypher.collect(name("d")))
            .build();

        Map<String, Object> parameters = new HashMap<>();
        parameters.put("person1", from.getName());
        parameters.put("person2", to.getName());
        return this.neo4jTemplate.findAll(statement, parameters, MovieEntity.class); 2
    }

}
Neo4jTemplate由运行时通过DomainResultsImpl的构造函数注入。无需@Autowired。使用 Cypher-DSL 构建一个复杂语句(与路径映射中所示的几乎相同)。该语句可以直接传给模板。
模板也有针对基于字符串查询的重载,因此您也可以把查询写成字符串。这里的关键要点是:
-
模板「知道」您的领域对象,并相应地映射它们
-
@Query不是定义自定义查询的唯一选项 -
它们可以通过多种方式生成
-
@Transactional注解会被遵守
使用自定义查询和自定义映射
很多时候,自定义查询意味着自定义结果。所有这些结果都应该映射为 @Node 吗?当然不是!很多时候这些对象表示的是读命令,并不打算用作写命令。SDN 也不太可能或并不打算映射 Cypher 所能表达的一切。不过,它确实提供了若干钩子,让您运行自己的映射:在 Neo4jClient 上。与直接使用驱动相比,使用 SDN 的 Neo4jClient 的好处在于:
-
Neo4jClient与 Spring 的事务管理集成 -
它具有用于绑定参数的流式 API
-
它具有一个流式 API,同时暴露记录(record)和 Neo4j 类型系统,这样您就可以访问结果中的一切来执行映射
声明这个片段与之前完全一样:
import java.util.Collection;

import org.springframework.data.neo4j.documentation.domain.MovieEntity;
import org.springframework.transaction.annotation.Transactional;

interface NonDomainResults {

    @Transactional(readOnly = true)
    Collection<Result> findRelationsToMovie(MovieEntity movie); 1

    class Result {

        2
        public final String name;

        public final String typeOfRelation;

        Result(String name, String typeOfRelation) {
            this.name = name;
            this.typeOfRelation = typeOfRelation;
        }

    }

}
这是一个虚构的非领域结果。真实世界的查询结果很可能更复杂。
该片段添加的方法。同样,该方法标注了 Spring 的
@Transactional
如果没有该片段的实现,启动将会失败,所以下面就是它的实现:
import java.util.Collection;

import org.springframework.data.neo4j.core.Neo4jClient;
import org.springframework.data.neo4j.documentation.domain.MovieEntity;

class NonDomainResultsImpl implements NonDomainResults {

    private final Neo4jClient neo4jClient; 1

    NonDomainResultsImpl(Neo4jClient neo4jClient) {
        this.neo4jClient = neo4jClient;
    }

    @Override
    public Collection<Result> findRelationsToMovie(MovieEntity movie) {
        return this.neo4jClient
            .query("" + "MATCH (people:Person)-[relatedTo]-(:Movie {title: $title}) " + "RETURN people.name AS name, "
                    + "       Type(relatedTo) as typeOfRelation") 2
            .bind(movie.getTitle())
            .to("title") 3
            .fetchAs(Result.class) 4
            .mappedBy((typeSystem, record) -> new Result(record.get("name").asString(),
                    record.get("typeOfRelation").asString())) 5
            .all(); 6
    }

}
这里我们使用由基础设施提供的
Neo4jClient。客户端只接受字符串,但在渲染成字符串时仍然可以使用 Cypher-DSL
把单个值绑定到一个命名参数上。还有一个重载可以绑定整个参数 map
这是您想要的结果类型
最后是
mappedBy方法,它为结果中的每一项暴露一个Record,并在需要时暴露驱动的类型系统。这就是您接入自定义映射的 API
整个查询在一个 Spring 事务的上下文中运行,在本例中是一个只读事务。
底层交互
有时您可能想从仓库进行批量加载,或删除整个子图,或以非常特定的方式与 Neo4j Java 驱动交互。这也是可以做到的。下面的示例展示了如何做:
interface LowlevelInteractions {

    int deleteGraph();

}

import org.neo4j.driver.Driver;
import org.neo4j.driver.Session;
import org.neo4j.driver.summary.SummaryCounters;

class LowlevelInteractionsImpl implements LowlevelInteractions {

    private final Driver driver; 1

    LowlevelInteractionsImpl(Driver driver) {
        this.driver = driver;
    }

    @Override
    public int deleteGraph() {

        try (Session session = this.driver.session()) {
            SummaryCounters counters = session.executeWrite(tx -> tx.run("MATCH (n) DETACH DELETE n").consume()) 2
                .counters();
            return counters.nodesDeleted() + counters.relationshipsDeleted();
        }
    }

}
直接使用驱动。与所有示例一样:不需要
@Autowired魔法。所有片段实际上都可以独立测试。这个用例是虚构的。这里我们使用一个由驱动管理的事务来删除整张图,并返回被删除的节点和关系的数量。
这种交互当然不在 Spring 事务中运行,因为驱动并不了解 Spring。
综合起来看,这个测试会通过:
@Test
void customRepositoryFragmentsShouldWork(@Autowired PersonRepository people, @Autowired MovieRepository movies) {

    PersonEntity meg = people.findById("Meg Ryan").get();
    PersonEntity kevin = people.findById("Kevin Bacon").get();

    List<MovieEntity> moviesBetweenMegAndKevin = movies.findMoviesAlongShortestPath(meg, kevin);
    assertThat(moviesBetweenMegAndKevin).isNotEmpty();

    Collection<NonDomainResults.Result> relatedPeople = movies
        .findRelationsToMovie(moviesBetweenMegAndKevin.get(0));
    assertThat(relatedPeople).isNotEmpty();

    assertThat(movies.deleteGraph()).isGreaterThan(0);
    assertThat(movies.findAll()).isEmpty();
    assertThat(people.findAll()).isEmpty();
}
最后说明一点:这三个接口及其实现都会被 Spring Data Neo4j 自动拾取,无需进一步配置。而且,同一个整体仓库也可以只用一个附加片段(定义了全部三个方法的接口)和一个实现来创建。那样的话,该实现就会注入全部三种抽象(模板、客户端和驱动)。
当然,这一切同样适用于响应式仓库。它们会使用 ReactiveNeo4jTemplate 和 ReactiveNeo4jClient,以及驱动提供的响应式会话。
如果您有所有仓库都需要的通用方法,可以替换掉默认的仓库实现。
如何使用自定义的 Spring Data Neo4j 基础仓库?
基本上与共享的 Spring Data Commons 文档中针对 Spring Data JPA 在自定义基础仓库一节所示的方式相同。只不过在我们这里,您要继承的是
public static class MyRepositoryImpl<T, ID> extends SimpleNeo4jRepository<T, ID> {

    MyRepositoryImpl(Neo4jOperations neo4jOperations, Neo4jEntityInformation<T, ID> entityInformation) {
        super(neo4jOperations, entityInformation); 1
    }

    @Override
    public List<T> findAll() {
        throw new UnsupportedOperationException("This implementation does not support `findAll`");
    }

}
这个签名是基类所要求的。获取
Neo4jOperations(Neo4jTemplate实际的规格说明)和实体信息,并在需要时把它们存到一个属性上。
在这个示例中,我们禁止使用 findAll 方法。您可以添加一些接收获取深度、并基于该深度运行自定义查询的方法。其中一种做法如DomainResults 片段所示。
要为所有已声明的仓库启用这个基础仓库,请用 @EnableNeo4jRepositories(repositoryBaseClass = MyRepositoryImpl.class) 启用 Neo4j 仓库。
我如何审计实体?
所有 Spring Data 注解都受支持。它们是:
-
org.springframework.data.annotation.CreatedBy -
org.springframework.data.annotation.CreatedDate -
org.springframework.data.annotation.LastModifiedBy -
org.springframework.data.annotation.LastModifiedDate
审计为您提供了在 Spring Data Commons 大背景下如何使用审计的总体认识。下面的清单列出了 Spring Data Neo4j 提供的每一个配置选项:
@Configuration
@EnableNeo4jAuditing(modifyOnCreate = false, 1
        auditorAwareRef = "auditorProvider", 2
        dateTimeProviderRef = "fixedDateTimeProvider" 3
)
class AuditingConfig {

    @Bean
    AuditorAware<String> auditorProvider() {
        return () -> Optional.of("A user");
    }

    @Bean
    DateTimeProvider fixedDateTimeProvider() {
        return () -> Optional.of(AuditingITBase.DEFAULT_CREATION_AND_MODIFICATION_DATE);
    }

}
如果您希望修改数据在创建时也被写入,则设为 true
使用此属性指定提供审计者(即用户名)的 Bean 的名称
使用此属性指定提供当前日期的 Bean 的名称。在本例中使用的是一个固定日期,因为上面的配置是我们测试的一部分
响应式版本基本相同,只是审计感知 Bean 的类型是 ReactiveAuditorAware,这样获取审计者就成了响应式流的一部分。
除这些审计机制之外,您还可以向上下文中添加任意多个实现了 BeforeBindCallback<T> 或 ReactiveBeforeBindCallback<T> 的 Bean。这些 Bean 会被 Spring Data Neo4j 拾取,并在实体持久化之前按顺序调用(前提是它们实现了 Ordered 或标注了 @Order)。
它们可以修改实体,也可以返回一个全新的实体。下面的示例向上下文添加了一个回调,它在实体持久化之前修改某个属性:
import java.util.UUID;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.data.neo4j.core.mapping.callback.AfterConvertCallback;
import org.springframework.data.neo4j.core.mapping.callback.BeforeBindCallback;
import org.springframework.data.neo4j.integration.shared.common.ThingWithAssignedId;

@Configuration
class CallbacksConfig {

    @Bean
    BeforeBindCallback<ThingWithAssignedId> nameChanger() {
        return entity -> {
            ThingWithAssignedId updatedThing = new ThingWithAssignedId(entity.getTheId(),
                    entity.getName() + " (Edited)");
            return updatedThing;
        };
    }

    @Bean
    AfterConvertCallback<ThingWithAssignedId> randomValueAssigner() {
        return (entity, definition, source) -> {
            entity.setRandomValue(UUID.randomUUID().toString());
            return entity;
        };
    }

}
无需额外配置。
如何使用「按示例查询」?
「按示例查询」是 SDN 中的一项新特性。您实例化一个实体,或使用一个已有的实体。用这个实例创建一个 org.springframework.data.domain.Example。如果您的仓库继承了 org.springframework.data.neo4j.repository.Neo4jRepository 或 org.springframework.data.neo4j.repository.ReactiveNeo4jRepository,就可以立即使用那些接收示例的 findBy 方法,如findByExample所示。
Example<MovieEntity> movieExample = Example.of(new MovieEntity("The Matrix", null));
Flux<MovieEntity> movies = this.movieRepository.findAll(movieExample);

movieExample = Example.of(
    new MovieEntity("Matrix", null),
    ExampleMatcher
        .matchingAny()
        .withMatcher(
            "title",
            ExampleMatcher.GenericPropertyMatcher.of(ExampleMatcher.StringMatcher.CONTAINING)
        )
);
movies = this.movieRepository.findAll(movieExample);
您也可以对个别属性取反。这会添加一个相应的 NOT 操作,从而把 = 变成 <>。所有标量数据类型和所有字符串运算符都受支持:
Example<MovieEntity> movieExample = Example.of(
    new MovieEntity("Matrix", null),
    ExampleMatcher
        .matchingAny()
        .withMatcher(
            "title",
            ExampleMatcher.GenericPropertyMatcher.of(ExampleMatcher.StringMatcher.CONTAINING)
        )
       .withTransformer("title", Neo4jPropertyValueTransformers.notMatching())
);
Flux<MovieEntity> allMoviesThatNotContainMatrix = this.movieRepository.findAll(movieExample);
使用 Spring Data Neo4j 需要 Spring Boot 吗?
不需要。虽然通过 Spring Boot 自动配置许多 Spring 方面能省去大量繁琐的手动工作,也是搭建新 Spring 项目的推荐方式,但您并非必须使用它。
上述方案需要以下依赖:
<dependency>
	<groupId>org.springframework.data</groupId>
	<artifactId>spring-data-neo4j</artifactId>
	<version>8.1.1</version>
</dependency>
Gradle 配置的依赖坐标相同。
要选择不同的数据库——无论是静态还是动态——您可以添加一个类型为 DatabaseSelectionProvider 的 Bean,如Neo4j 4 支持多个数据库——我该如何使用它们?中所述。对于响应式场景,我们提供了 ReactiveDatabaseSelectionProvider。
在不使用 Spring Boot 的 Spring 上下文中使用 Spring Data Neo4j
我们提供了两个抽象配置类来帮助您引入所需的 Bean:用于命令式数据库访问的 org.springframework.data.neo4j.config.AbstractNeo4jConfig,以及用于响应式版本的 org.springframework.data.neo4j.config.AbstractReactiveNeo4jConfig。它们分别配合 @EnableNeo4jRepositories 和 @EnableReactiveNeo4jRepositories 使用。用法示例请参阅为命令式数据库访问启用 Spring Data Neo4j 基础设施和为响应式数据库访问启用 Spring Data Neo4j 基础设施。这两个类都要求您重写 driver(),您应在其中创建驱动。
要获得命令式版本的Neo4j 客户端、模板以及对命令式仓库的支持,请使用与下面类似的配置:
import org.neo4j.driver.Driver;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import org.springframework.transaction.annotation.EnableTransactionManagement;

import org.springframework.data.neo4j.config.AbstractNeo4jConfig;
import org.springframework.data.neo4j.core.DatabaseSelectionProvider;
import org.springframework.data.neo4j.repository.config.EnableNeo4jRepositories;

@Configuration
@EnableNeo4jRepositories
@EnableTransactionManagement
class MyConfiguration extends AbstractNeo4jConfig {

    @Override @Bean
    public Driver driver() { 1
        return GraphDatabase.driver("bolt://localhost:7687", AuthTokens.basic("neo4j", "secret"));
    }

    @Override
    protected Collection<String> getMappingBasePackages() {
        return Collections.singletonList(Person.class.getPackage().getName());
    }

    @Override @Bean 2
    protected DatabaseSelectionProvider databaseSelectionProvider() {

        return DatabaseSelectionProvider.createStaticDatabaseSelectionProvider("yourDatabase");
    }
}
驱动 Bean 是必需的。
这会静态选择一个名为
yourDatabase的数据库,并且是可选的。
下面的清单提供了响应式 Neo4j 客户端和模板,启用了响应式事务管理,并发现了 Neo4j 相关仓库:
import org.neo4j.driver.Driver;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.data.neo4j.config.AbstractReactiveNeo4jConfig;
import org.springframework.data.neo4j.repository.config.EnableReactiveNeo4jRepositories;
import org.springframework.transaction.annotation.EnableTransactionManagement;

@Configuration
@EnableReactiveNeo4jRepositories
@EnableTransactionManagement
class MyConfiguration extends AbstractReactiveNeo4jConfig {

    @Bean
    @Override
    public Driver driver() {
        return GraphDatabase.driver("bolt://localhost:7687", AuthTokens.basic("neo4j", "secret"));
    }

    @Override
    protected Collection<String> getMappingBasePackages() {
        return Collections.singletonList(Person.class.getPackage().getName());
    }
}
在 CDI 2.0 环境中使用 Spring Data Neo4j
为方便起见,我们通过 Neo4jCdiExtension 提供了一个 CDI 扩展。当在兼容的 CDI 2.0 容器中运行时,它会通过 Java 的服务加载器 SPI 自动注册和加载。
您需要带入应用的唯一东西,是一个能产生 Neo4j Java 驱动的带注解类型:
import javax.enterprise.context.ApplicationScoped;
import javax.enterprise.inject.Disposes;
import javax.enterprise.inject.Produces;

import org.neo4j.driver.AuthTokens;
import org.neo4j.driver.Driver;
import org.neo4j.driver.GraphDatabase;

public class Neo4jConfig {

    @Produces @ApplicationScoped
    public Driver driver() { 1
        return GraphDatabase
            .driver("bolt://localhost:7687", AuthTokens.basic("neo4j", "secret"));
    }

    public void close(@Disposes Driver driver) {
        driver.close();
    }

    @Produces @Singleton
    public DatabaseSelectionProvider getDatabaseSelectionProvider() { 2
        return DatabaseSelectionProvider.createStaticDatabaseSelectionProvider("yourDatabase");
    }
}
与为命令式数据库访问启用 Spring Data Neo4j 基础设施中的纯 Spring 相同,只不过加上了相应 CDI 基础设施的注解。
这是可选的。但是,如果您运行了自定义数据库选择提供器,那么您_必须_不要给这个 Bean 加限定符。
如果您运行在一个 SE 容器中——例如 Weld 所提供的那种——可以像这样启用该扩展:
import javax.enterprise.inject.se.SeContainer;
import javax.enterprise.inject.se.SeContainerInitializer;

import org.springframework.data.neo4j.config.Neo4jCdiExtension;

public class SomeClass {
    void someMethod() {
        try (SeContainer container = SeContainerInitializer.newInstance()
                .disableDiscovery()
                .addExtensions(Neo4jCdiExtension.class)
                .addBeanClasses(YourDriverFactory.class)
                .addPackages(Package.getPackage("your.domain.package"))
            .initialize()
        ) {
            SomeRepository someRepository = container.select(SomeRepository.class).get();
        }
    }
}